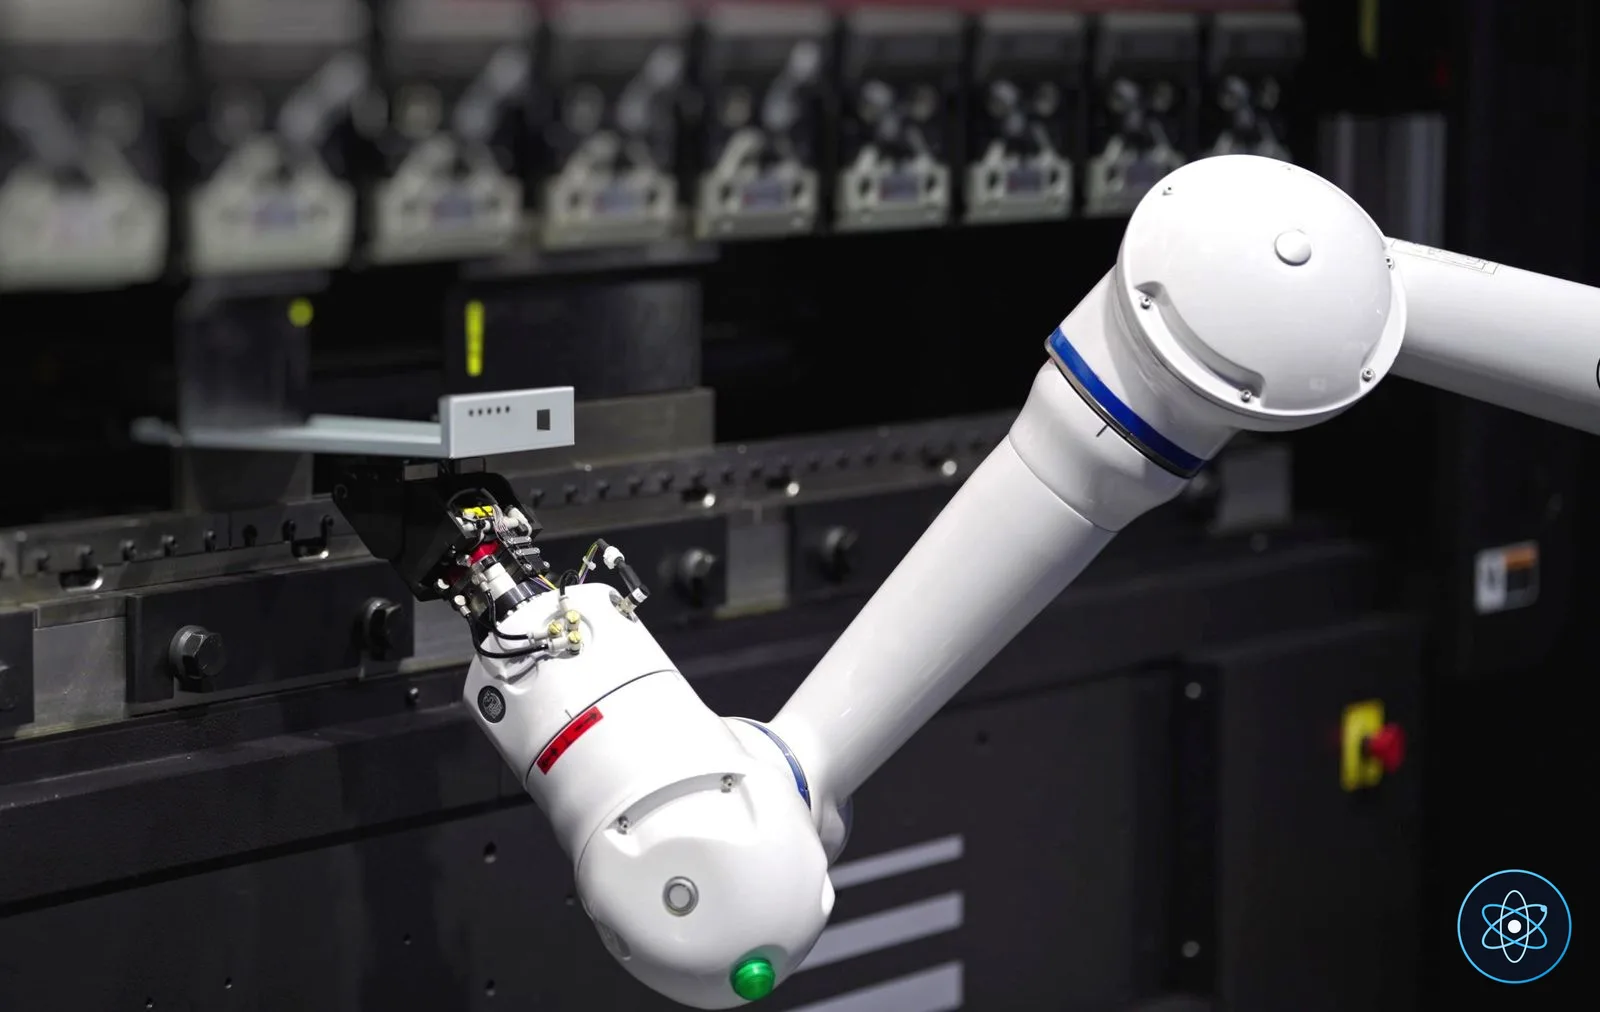
Представьте, что вы объясняете роботу, как приготовить кофе. «Возьми зерна, насыпь в кофемолку, перемели, засыпь в фильтр…». Раньше такие многошаговые инструкции ставили машины в тупик. Но теперь учёные разработали новый подход, который помогает роботам лучше понимать и выполнять команды. Суть в том, чтобы робот не просто «слушал» слова, а «видел» результат выполнения каждого шага.
Исследователи из Университета Карнеги — Меллон создали систему, которая генерирует предсказанные изображения. Когда роботу дают голосовую инструкцию, например, «поставь эту чашку на полку», система сначала просчитывает, как будет выглядеть комната после выполнения команды. Затем она использует эти предсказанные изображения, чтобы направлять свои движения. Это похоже на то, как человек может представить конечный результат, чтобы спланировать свои действия.
Такой метод особенно полезен для задач, требующих последовательности действий и точного позиционирования. Вместо того чтобы просто следовать линейным командам, робот теперь может «понимать» контекст и конечную цель. Это открывает двери для более сложных и автономных робототехнических систем, которые смогут справляться с задачами в реальном мире, от сборки на производстве до помощи по дому.
Эксперименты показали, что роботы, оснащённые этой системой, значительно лучше справляются с выполнением сложных, многоэтапных инструкций по сравнению с теми, кто полагается только на традиционные методы обработки языка и движений. Это шаг к тому, чтобы роботы стали более интуитивными и полезными помощниками.