В бескрайних просторах космоса, среди гигантских облаков газа и пыли, скрываются миллионы различных молекул. Найти их — задача не из легких. Астрономы используют радиотелескопы, чтобы улавливать сигналы от этих молекул, но спектр возможных сигналов настолько огромен, что поиск напоминает попытку найти иголку в стоге сена.
Недавно учёные решили применить к этой задаче машинное обучение — технологию, которая уже успешно используется во многих сферах, от рекомендаций фильмов до диагностики заболеваний. Идея состоит в том, чтобы «обучить» компьютер распознавать сигналы молекул и помогать астрономам быстрее находить новые. Но тут возник вопрос: можно ли сделать этот процесс ещё эффективнее?
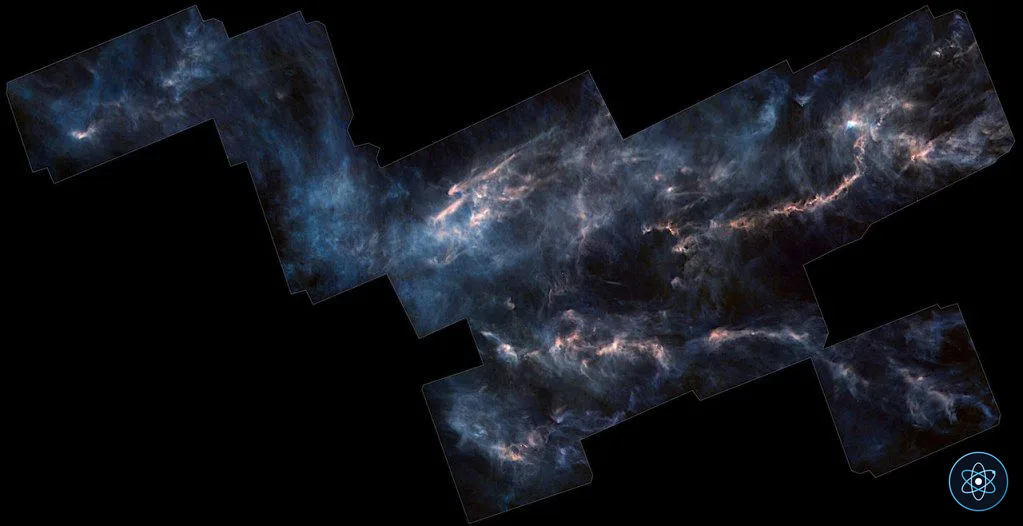
Исследователи из NASA и других учреждений провели ретроспективный тест, изучая уже собранные данные о молекуле в одном из самых известных межзвездных облаков — TMC-1 (Taurus Molecular Cloud 1). Это облако находится примерно в 450 световых годах от Земли и является настоящей «химической лабораторией» космоса, где учёные уже обнаружили множество сложных органических соединений. Именно в TMC-1 была впервые найдена молекула, содержащая серу, что стало важным шагом в понимании химических процессов во Вселенной.
Учёные использовали алгоритм «активного обучения» (active learning). Представьте, что вы ищете определённый тип цветов на огромном поле. Активное обучение похоже на то, как если бы вы не просто осматривали поле случайным образом, а сначала выбрали несколько участков, где цветы, скорее всего, есть, на основе прошлых наблюдений. Затем, найдя там что-то, вы корректируете свою стратегию поиска, чтобы ещё точнее определить, где искать дальше.
В данном исследовании алгоритм сначала получил список молекул, которые могли бы быть обнаружены в TMC-1, основываясь на известных химических процессах. Затем, по мере того как учёные «находили» (то есть идентифицировали сигналы) новые молекулы, алгоритм анализировал эти результаты. Его задача заключалась в том, чтобы переранжировать список оставшихся молекул, отдавая приоритет тем, которые с наибольшей вероятностью могли быть найдены дальше, учитывая уже известные находки. Эта «обратная связь» от реальных наблюдений помогала алгоритму становиться умнее и точнее.
Результаты показали, что такой подход действительно работает. Динамическое обновление рекомендаций, основанное на накопленных данных, оказалось более эффективным, чем простое использование первоначального списка. Это означает, что, применяя активное обучение, астрономы смогут быстрее находить новые, возможно, даже ещё более сложные молекулы в космических облаках. Это не только ускорит научные открытия, но и поможет нам лучше понять, как зарождалась и развивается химия во Вселенной, и, возможно, приблизиться к ответу на вопрос о существовании жизни за пределами Земли.